

1. 서 론
2. 선행연구
2.1 객체 탐지를 위한 능동학습
2.2 영상 시간 정보를 활용한 능동학습
2.3 선행연구 한계 및 연구목적
3. 방법론
3.1 연구 프레임워크
3.2 시간적 일관성 기반 Interpolation 쿼리
4. 실 험
4.1 데이터 및 학습 절차
4.2 평가방법
5. 연구결과
5.1 미탐 후보 선별 결과
5.2 누적 평가 결과
5.3 다음날 일반화 성능 평가
6. 고 찰
7. 결 론
1. 서 론
건설현장은 작업자와 건설장비가 제한된 공간에서 동시다발적으로 작업하고 공정 진행에 따라 작업 환경이 지속적으로 변화하므로 현장 상황을 파악하기 위한 모니터링이 필수적이다(Kim et al., 2019; Hwang et al., 2025). 건설현장 모니터링에서 객체 탐지는 작업자와 장비의 종류 및 위치를 식별하는 기술로 작업행동 분석과 위험상황을 판단하기 위한 정보를 제공한다.
그러나 다양한 건설현장에서 수집된 오픈소스 데이터를 통해 사전학습된 객체 탐지 모델을 실제 건설현장에 적용할 경우 학습 데이터와 현장 영상 간의 데이터 분포 차이로 인해 충분한 객체 탐지 성능을 확보하기 어려울 수 있다. 특히 촬영 시점, 조명 및 기상조건, 공정 단계에 따른 작업환경의 변화는 동일한 현장에서도 객체의 시각적 특성을 변화시키므로 현장에서 지속적으로 수집되는 데이터를 활용한 모델의 업데이트가 요구된다(Nath and Behzadan, 2020). 이러한 과정에서 객체의 종류와 위치를 표시하는 라벨링 과정에 상당한 인력과 시간이 소요된다는 점을 고려하면 제한된 라벨링 예산 내에서 성능 개선에 기여하기 위한 학습 데이터를 선별하는 것이 중요하다(Kim et al., 2020).
능동학습(active learning)은 학습에 유용할 것으로 판단되는 데이터를 선택하고 해당 데이터의 라벨을 확보하여 모델을 반복적으로 갱신함으로써 라벨링 효율을 높이는 접근방식이다. 건설 분야에서도 대규모 사전 데이터베이스 구축 부담을 줄이기 위해 현장 영상의 예측 불확실성을 기반으로 학습 데이터를 선별하는 능동학습 방법이 제안되었다(Kim et al., 2020). 능동학습에서 데이터 선별 전략인 쿼리(query)는 제한된 예산으로 학습을 위한 데이터를 결정하므로 현장 모델의 탐지 오류를 효과적으로 반영하기 위해 설계될 필요가 있다.
본 연구에서는 객체 탐지 오류 중 객체가 검출되지 않는 미탐(false negative) 정보를 활용하여 데이터를 선별하고자 한다. 검출된 객체의 예측 신뢰도만을 이용하는 불확실성(uncertainty) 기반 접근방식은 검출 결과가 생성되지 않는 객체의 존재와 위치를 파악하기 어렵다. 반면, 영상의 시간적 일관성을 활용하면 전후 프레임의 검출 결과를 근거로 중간 프레임의 미탐 가능성을 추정할 수 있으며 이러한 시간 정보를 이용하여 미탐을 추정하고 학습 데이터를 선별할 수 있다(Bengar et al., 2019).
이에 본 연구에서는 전후 프레임의 검출 위치를 보간하여 중간 프레임의 미탐 후보를 추정하는 Interpolation 쿼리를 제안하고, 이를 능동학습 절차에 적용하여 제한된 라벨링 예산 하에서 건설현장 객체 탐지 성능의 개선 가능성을 검토한다. 실제 건설현장에서 수집한 10일간의 영상을 대상으로 동일한 수의 프레임을 선별하고 모델을 업데이트하여 제안 방법의 미탐 후보 선별 정확도와 무작위 선별 대비 탐지 성능을 평가한다. 특히 학습 데이터 누적에 따른 성능 변화와 다음날 영상에 대한 일반화 성능을 구분하여 분석함으로써 미탐 중심의 데이터 선별이 현장 모델의 적응에 미치는 효과와 한계를 실증적으로 제시하고자 한다.
2. 선행연구
2.1 객체 탐지를 위한 능동학습
능동학습은 제한된 라벨링 예산 내에서 학습에 유용한 데이터를 선택하고 오라클로부터 제공받은 정답 라벨을 활용하여 모델을 반복적으로 갱신하는 학습 전략이다. 이때 데이터의 선택 기준을 정의하는 쿼리 전략은 라벨링 예산의 배분과 학습 데이터의 구성을 결정하여 능동학습의 성능에 영향을 준다. 대표적으로 예측 불확실성을 이용하는 방법과 데이터의 대표성을 고려하는 방법 등이 있으며 적용 과제의 특성에 따라 다양한 선별 기준이 제안되었다(Settles, 2009).
객체 탐지는 객체의 종류와 위치를 동시에 추정하므로 분류 신뢰도만으로 표본의 학습 유용성을 평가하는 데에는 한계가 있다. 이에 Kao et al. (2019)은 영역 제안 박스와 최종 검출 박스의 중첩 정도, 입력 영상에 노이즈를 추가했을 때 발생하는 변화를 이용하여 위치 추정의 불확실도를 선별기준으로 활용하였다. Choi et al. (2021)은 혼합밀도 네트워크를 이용하여 분류 및 위치 출력의 확률분포를 모델링하고 데이터에 내재된 불확실성과 모델의 지식 부족에 따른 불확실성을 함께 평가하는 방법을 제안하였다.
예측 불확실성뿐만 아니라 데이터 집합의 대표성이나 학습 손실을 이용하는 접근도 이루어지고 있다. Sener and Savarese (2018)는 이미지 분류를 대상으로 벡터 공간에서 전체 데이터의 분포를 포괄하는 부분집합을 선택하는 core-set 방법을 제안하여 개별 표본뿐 아니라 선택된 표본 집합의 구성도 중요함을 제시하였다. Yoo and Kweon (2019)은 라벨이 없는 데이터의 학습 손실을 예측하는 모듈을 도입하고 예상 손실이 큰 표본을 우선 선택하는 방법을 객체 탐지를 포함한 여러 과제에서 검증하였다.
건설 분야에서는 현장별 학습 데이터 구축 부담을 줄이기 위한 능동학습 연구가 수행되었다. Kim et al. (2020)은 검출 박스의 예측 엔트로피를 이미지 단위로 집계하여 학습 데이터를 선별하고 사용자 라벨링과 재학습을 반복하는 방법을 제안하였다. 해당 연구를 통해 무작위 선별보다 적은 이미지로 목표 탐지 성능을 확보하여 현장 데이터 선별의 효과를 확인하였다. 또한, Mannem et al. (2026)은 분류 신뢰도, 클래스 엔트로피 및 검출 박스의 변동을 반영한 불확실도와 벡터 공간의 다양성을 결합하여 소규모 불균형 건설 데이터에서의 학습 효율을 개선하였다.
2.2 영상 시간 정보를 활용한 능동학습
영상의 시간 정보는 프레임 간 중복을 줄이는 데 활용될 뿐 아니라 주석의 필요성과 예측 불확실성을 판단하는 근거로 활용된다. 객체 탐지를 대상으로 한 Schmidt et al. (2020)의 연구에서는 연속 프레임에서 검출된 동일 객체의 영역을 대응시켜 시간 구간에 걸친 분류 불확실도를 추정하였다. 이는 시간 정보를 개별 프레임의 예측 신뢰도를 보완하는 신호로 활용한 접근방식이다.
시간적 일관성을 이용하여 탐지 오류를 추정하는 연구도 제안되었다. Bengar et al. (2019)은 검출 박스를 시간의 양방향으로 추적하고 검출 결과와 미탐 후보 간의 관계를 통해 오탐과 미탐을 추정하였다. 이러한 연구는 주변 프레임의 검출결과가 현재 프레임에서 누락된 객체의 존재를 추정하는 근거가 될 수 있음을 보여주는 연구결과이다.
건설현장에서도 연속적으로 수집되는 영상을 활용하여 모델을 갱신하는 접근 방식이 제안되고 있다. Hwang et al. (2025)은 최근 프레임들의 검출 신뢰도를 이용하여 모델 갱신 필요성을 판단하고 현장에 맞게 구성한 학습 데이터베이스로 갱신하는 online-active learning 기반 모니터링 체계를 제안하였다. 해당 연구는 시간에 따른 현장 변화에 대응하는 운영 절차를 제시하였다.
2.3 선행연구 한계 및 연구목적
선행연구에서는 영상의 시간적 일관성을 이용하여 탐지 오류를 추정하고 학습 데이터를 선별하는 방법을 제안하였다. 그러나 미탐 후보를 우선 선별하는 전략이 제한된 라벨링 예산으로 모델을 지속적으로 갱신하는 건설현장에서 다음날 영상에 대한 일반화 성능 개선으로 이어지는지에 대한 검증이 제한적이다. 이에 본 연구는 전후 프레임의 바운딩 박스를 매칭하고 보간하여 중간 프레임의 미탐 후보를 선별하는 Interpolation 쿼리를 구성하여 실제 건설현장에서 수집한 10일간의 영상을 대상으로 동일한 예산 하에서 무작위 선별방식과 비교한다. 특히 미탐 후보의 선별 타당성을 확인하고 다음날 영상에 대한 일반화 성능을 평가함으로써 미탐 중심의 데이터 선별이 현장 모델의 적응에 기여하는 효과와 한계를 검토한다.
3. 방법론
3.1 연구 프레임워크
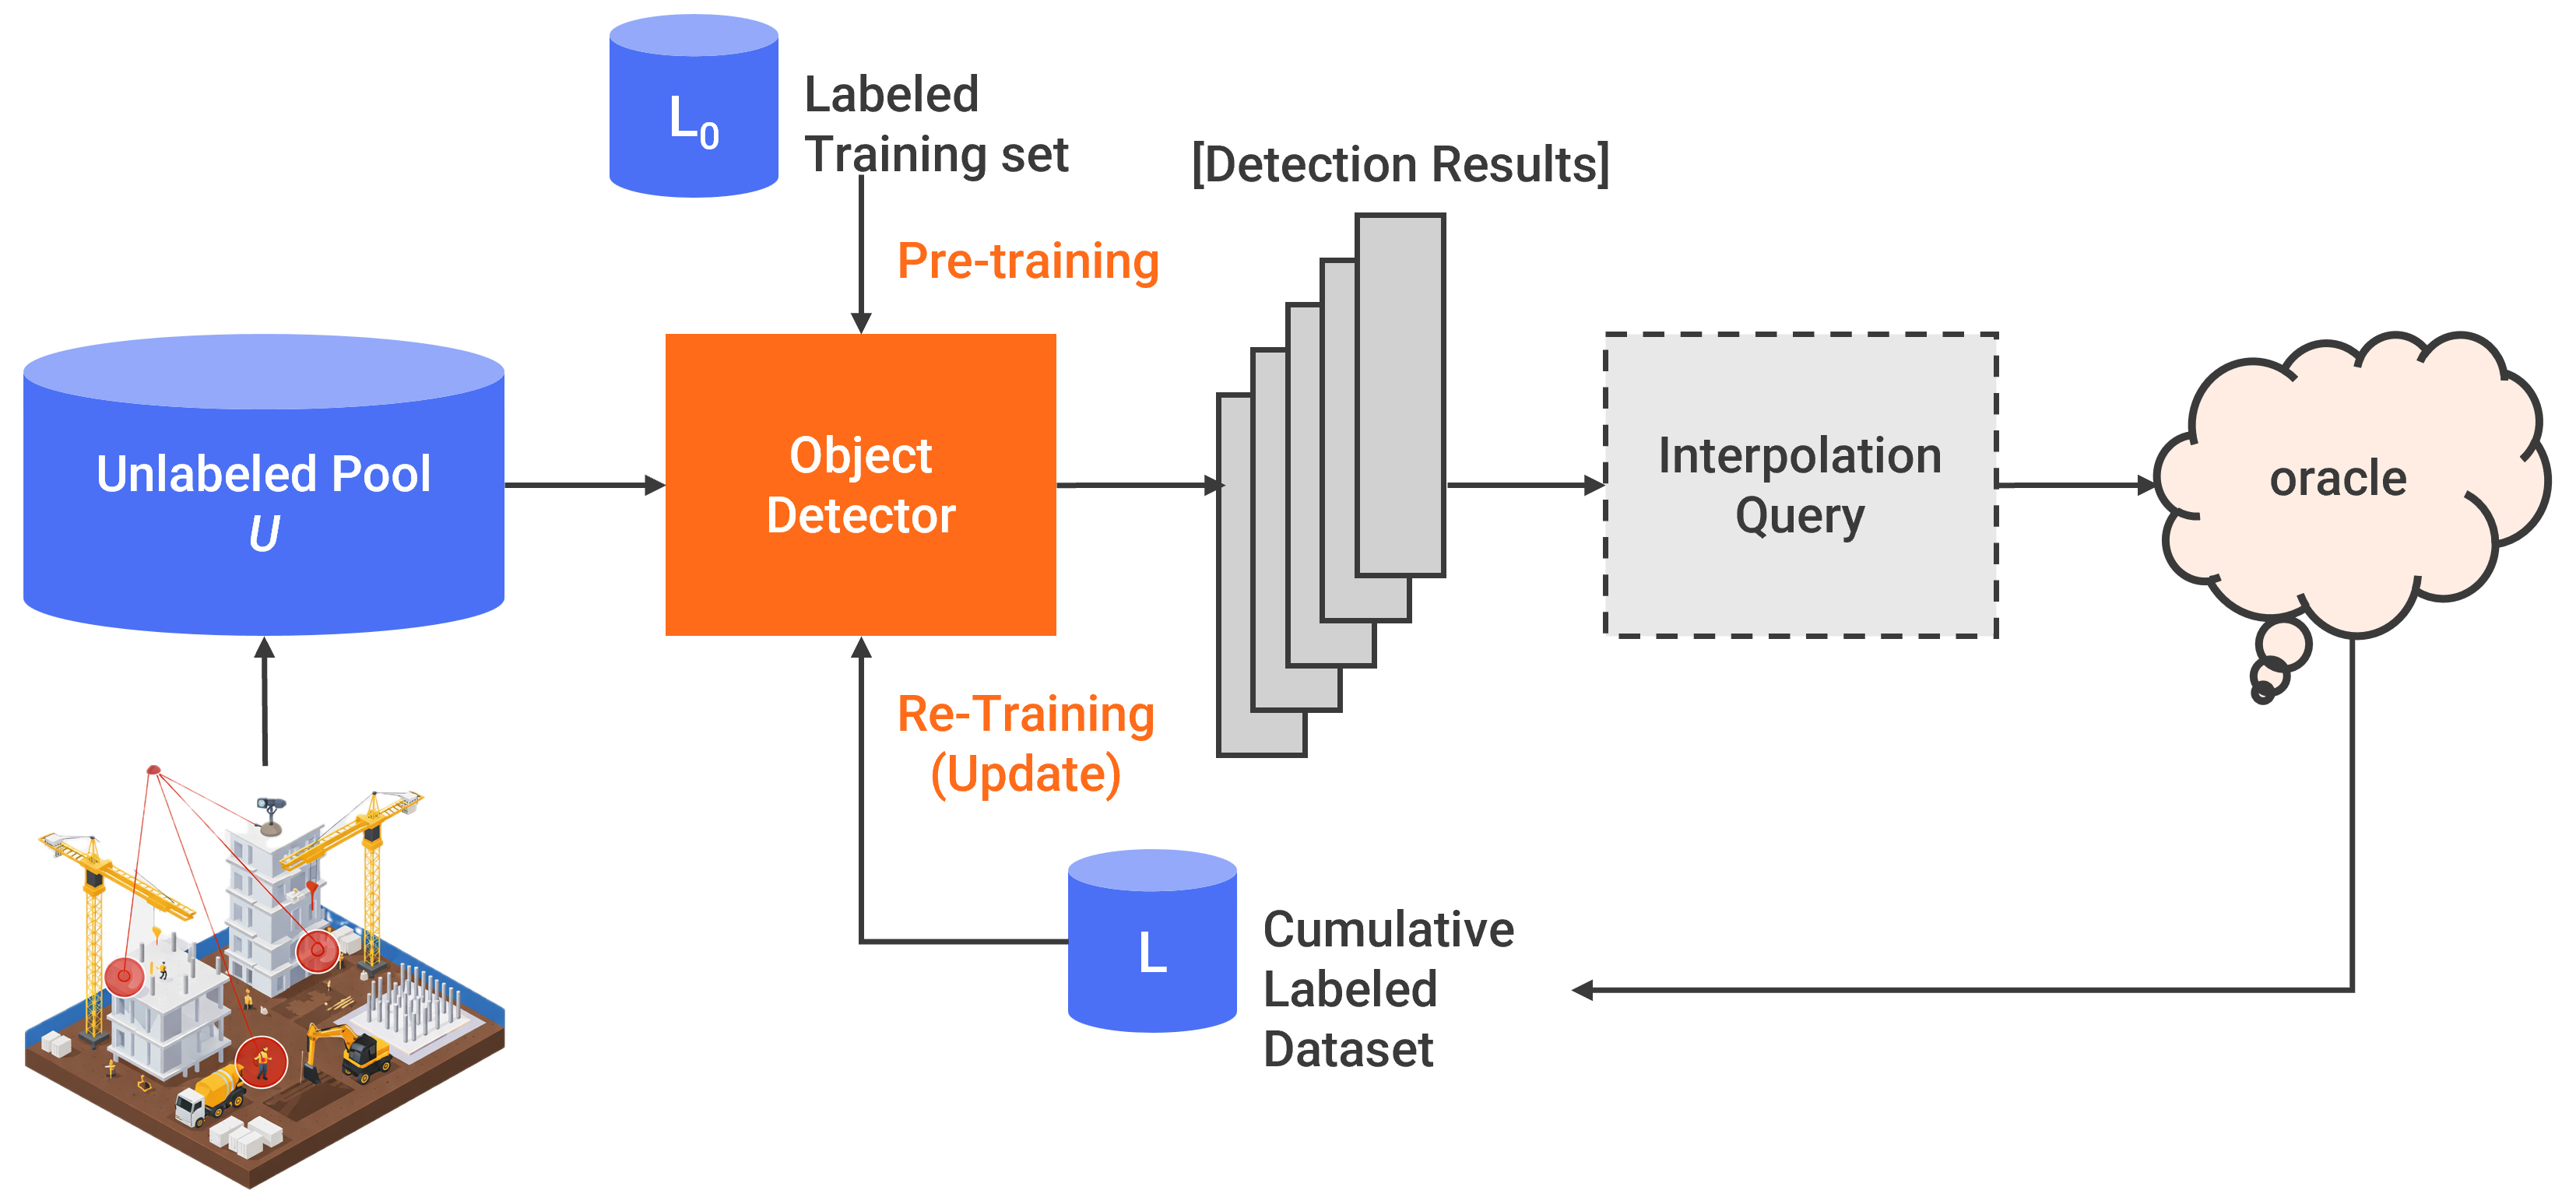
본 연구는 시간적 일관성을 이용하여 미탐 가능성이 있는 프레임을 선별하고 이를 객체 탐지 모델의 추가 학습에 활용하는 능동학습 프레임워크를 제안한다. 프레임워크는 사전학습, 현장에서 수집되는 영상에 대한 객체 탐지, Interpolation 쿼리를 이용한 프레임 선별, 오라클을 통한 정답 라벨 확보 및 모델 재학습으로 구성되며 전체 프레임워크는 Fig. 1과 같다.
건설현장 오픈소스 데이터셋을 활용하여 사전학습 모델을 구축하고, 객체 탐지 모델을 당일 수집된 영상에 적용하여 프레임별 바운딩 박스, 클래스를 생성한다. Interpolation 쿼리는 전후 프레임의 결과를 이용하여 중간 프레임의 미탐 후보를 추정하고 정해진 예산 내에서 라벨링 대상 프레임을 선별한다. 이후 오라클로부터 선택된 프레임의 정답 라벨을 확보하고 이를 기존 학습 데이터에 추가하여 모델을 재학습한다. 갱신된 모델은 다음날 수집되는 영상의 객체 탐지와 프레임 선별에 사용되며 이러한 과정을 반복한다.
3.2 시간적 일관성 기반 Interpolation 쿼리
Interpolation 쿼리는 짧은 시간 구간에서 동일 객체의 위치와 크기가 연속적으로 변화한다는 가정에 기반한다. 특정 객체가 전후 프레임에서 검출되었으나 중간 프레임의 대응 위치에서 검출되지 않은 경우 해당 위치를 미탐 후보로 추정한다. 이때 전후 프레임의 검출 결과만으로 실제 객체의 존재를 확정할 수 없으므로 Interpolation 쿼리 결과는 라벨링 대상 프레임을 선별하기 위한 판단근거로 활용한다.
검출 결과를 원본 영상과 프레임 번호에 따라 그룹화하고 정렬한 뒤 바운딩 박스의 중심점이 관심영역(region of interest, ROI) 내부에 위치한 바운딩 박스를 분석 대상으로 사용한다. 기준 프레임이 , 탐색 간격을 이라고 할 때, 전후 프레임 과 에서 동일 클래스에 속하는 바운딩 박스를 추출한다. 이후 박스의 중첩 정도와 중심점 거리 등 공간적 대응 조건에 따라 두 프레임의 박스를 일대일로 매칭하고, 대응된 박스 쌍을 보간을 위한 시간적 근거로 사용한다.
바운딩 박스를 중심 좌표와 너비 및 높이로 구성된 벡터 로 정의하면 프레임 에서의 기대 박스 는 다음과 같이 산정된다(식 (1)).
여기에서 과 은 동일 객체에 대응하는 것으로 판단된 전후 프레임의 바운딩 박스이다. 두 프레임이 기준 프레임으로부터 동일한 시간 간격에 위치하므로 각 박스의 중심 좌표와 크기를 선형 보간하여 중간 프레임의 기대 위치와 크기를 추정한다.
다음으로 기대 박스와 프레임 의 동일 클래스 바운딩 박스를 비교하여 해당 객체의 검출 여부를 판단한다. 비교지표로 각 박스 간 중첩 정도를 나타내는 IoU(intersection over union)와 기대 박스의 면적 중 현재 검출 박스가 포함하는 비율인 coverage를 사용하게 된다. 현재 프레임의 바운딩 박스를 라고 할 때, 두 지표는 다음과 같다(식 (2), (3)).
동일 클래스의 바운딩 박스 중 IoU가 0.3 이상이거나 coverage가 0.7 이상인 박스가 존재하면 해당 기대 박스는 검출된 객체에 대응하는 것으로 판단하고 두 기준 중 어느 것도 충족하는 동일 클래스 검출이 없으면 기대 박스를 미탐 후보로 유지한다.
현재 프레임에 동일 클래스의 검출 결과가 없는 경우에도 해당 기대 박스를 미탐 후보로 유지한다. 각 후보의 점수는 전후 시간 앵커의 검출 신뢰도, 위치 및 크기의 일치 정도, 기대 박스의 면적을 고려하여 산정하며, 대응 위치에 다른 클래스의 검출 결과가 존재하는 경우에는 후보 점수에 감점을 적용한다. 하나의 프레임에 여러 미탐 후보가 존재하면 후보 점수를 합산하여 프레임 점수를 산정한다. 프레임 선별은 작은 탐색 간격부터 순차적으로 수행하며, 각 탐색 간격 내에서는 프레임 점수가 높은 순서로 선별한다. 유사한 장면의 반복 선택을 제한하기 위해 동일 영상에서 선택되는 프레임 간에는 최소 15프레임의 간격을 적용한다. 탐색은 에서 시작하며, 선택된 프레임 수가 일별 예산 에 도달하지 않으면 을 증가시켜 추가 후보를 탐색한다. 선택 수가 예산에 도달하거나 최대 탐색 간격 까지 탐색을 완료하면 선별을 종료한다. Interpolation 쿼리를 통한 데이터 선별 전략은 Table 1과 같다.
Table 1
Pseudocode of the temporal consistency-based Interpolation query
4. 실 험
4.1 데이터 및 학습 절차
단일 건설현장에서 수집한 영상 중 1–10일차 데이터를 대상으로 하루 단위의 프레임 선별, 정답 라벨 확보 및 모델 재학습을 수행하였다. 다음날 일반화 성능 평가에는 2–11일차 테스트 데이터를 사용하였으며, 11일차 데이터는 평가에만 활용하였다. 일별 라벨링 예산은 100개 프레임으로 설정하였으며 각 선별 전략을 통하여 10일간 총 1,000개의 프레임을 확보하였다.
객체 탐지에는 YOLO26n 모델(Jocher et al., 2026)을 사용하였으며, 공개 건설현장 데이터셋인 SODA(Duan et al., 2022), MOCS(Xuehui et al., 2021), ACID(Xiao and Kang, 2021) 및 AI-Hub의 건설 현장 위험 상태 판단 데이터(National Information Society Agency, 2022)를 이용하여 초기 사전학습 모델을 구축하였다.
프레임 선별에 필요한 검출 결과는 직전 학습일의 모델을 이용하여 생성하였다. 선별된 프레임의 정답 라벨을 확보한 후 해당일까지 누적된 현장 데이터와 사전학습 데이터를 활용하여 모델을 재학습하였다. 이때, 각 학습일의 재학습은 동일한 사전학습 모델 가중치를 활용하였다. 직전 학습일의 모델은 쿼리를 위한 검출 결과 생성에 사용하고 모델 재학습은 공통 초기 가중치와 누적 학습 데이터를 이용하여 수행하였다.
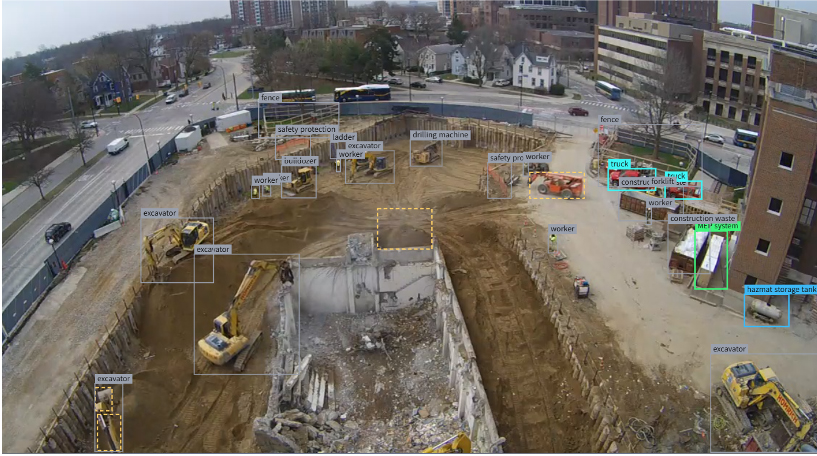
오라클은 선택된 프레임에 대해 정답 라벨을 제공한다. 프레임이 선택되면 보간으로 제안된 미탐 후보뿐만 아니라 해당 프레임에 포함된 전체 객체의 정답 라벨을 학습에 사용하였다 (Fig. 2).
제안하는 쿼리의 활용가능성을 평가하기 위해 무작위 프레임을 선별하는 랜덤 쿼리 전략과 서로 다른 3개의 시드로 각각 반복하여 비교 평가하였다. 반복 실험 간에는 학습용 프레임 선별 풀, 테스트 데이터, 초기 사전학습 가중치, 일별 라벨링 예산 및 학습 조건을 동일하게 유지하였다. 각 반복에서는 1–10일차의 모델 재학습 과정을 시드별로 수행하였으며, Random 전략의 모델 학습에도 동일한 시드를 적용하였다.
4.2 평가방법
제안하는 방법은 미탐 후보 선별 타당성과 선별된 데이터를 이용한 학습 효과 측면에서 평가하였다. 미탐 후보의 선별 결과는 프레임 적중률과 제안 박스 정밀도로 평가하였다. 참조 라벨과의 IoU가 0.3 이상이면서 모든 기존 검출 박스와의 IoU가 0.3 미만인 제안 박스를 올바른 미탐 후보로 판단하였다. 이때, 미탐 후보와 참조 라벨을 비교하는 과정에서 클래스의 일치 여부는 고려하지 않았다. 본 평가의 목적은 객체의 정확한 분류가 아닌 라벨링이 필요한 객체가 해당 영역에 존재하는지를 확인하는 데 있기 때문이다. Interpolation으로 생성된 후보 박스는 전후 프레임의 검출 결과를 보간한 근사 영역이므로 위치와 크기의 오차를 일부 허용하면서 공간적 대응을 확인하기 위해 클래스를 구분하지 않고 IoU 0.3을 적용하였다. 따라서 프레임 적중률과 제안 박스 정밀도는 해당 기준에서의 미탐 후보 선별 타당성을 나타내며 최종 객체 탐지 모델의 분류 및 위치 추정 성능과 구분된다.
프레임 적중률은 선택한 프레임 중 올바른 미탐 후보가 하나 이상 포함된 프레임의 비율이며, 제안 박스 정밀도는 전체 제안 박스 중 올바른 미탐 후보의 비율이다. 두 지표를 통해 쿼리가 제안한 미탐 후보와 실제 객체가 일치하는 정도를 확인하였다.
객체 탐지 성능은 IoU 0.5를 기준으로 산출한 클래스별 평균정밀도(AP)의 평균인 mAP50으로 평가하였다. 객체 탐지 성능 평가에는 학습용 프레임 선별 풀과 별도로 분리한 테스트 데이터를 사용하였다. 해당 데이터는 모델 학습 및 프레임 선별을 위한 추론에 사용하지 않고, 성능 평가에만 활용하였다. 누적평가는 해당일까지 학습한 모델을 초기부터 해당일까지 날짜별 테스트 데이터에 각각 적용하고 날짜별 mAP50을 산술평균하여 산정하였다. 다음날 평가는 해당일까지 학습한 모델을 바로 다음날의 데이터에 적용하여 수행하였다. 이는 학습에 반영되지 않은 영상에 대한 일반화 성능을 측정하는 방식으로 일별 모델 갱신의 효과를 평가하는 기준으로 사용하였다.
5. 연구결과
5.1 미탐 후보 선별 결과
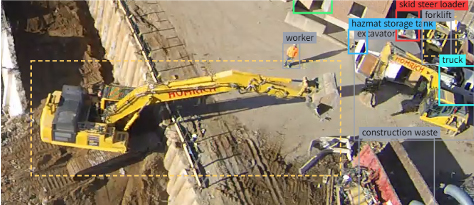
Interpolation 쿼리가 제안한 미탐 후보를 참조 라벨 및 기존 검출 결과와 비교하였다. Fig. 3은 Interpolation 쿼리로 선별한 미탐 후보의 예시이다.
일별 프레임 적중률과 제안박스 정밀도는 Table 2와 Fig. 4와 같다. 프레임 적중률은 63.0–99.0%, 제안 박스 정밀도는 50.0–87.8%로 나타났다. 전체 기간을 기준으로 프레임 적중률은 87.9%, 제안 박스 정밀도는 74.0%였다. 이는 선택한 1,000개 프레임 중 879개 프레임에서 올바른 미탐 후보가 하나 이상 확인되었으며, 전체 제안 박스의 74.0%가 미탐 후보 판정 기준을 충족하였음을 의미 한다.
Table 2
Frame hit rate and proposal box precision by day
| day | Frame hit-rate (%) | Proposal box precision (%) |
| 1 | 89.0 | 87.8 |
| 2 | 92.0 | 74.5 |
| 3 | 95.0 | 75.2 |
| 4 | 99.0 | 82.2 |
| 5 | 95.0 | 84.1 |
| 6 | 86.0 | 69.3 |
| 7 | 83.0 | 65.2 |
| 8 | 95.0 | 78.8 |
| 9 | 82.0 | 72.2 |
| 10 | 63.0 | 50.0 |
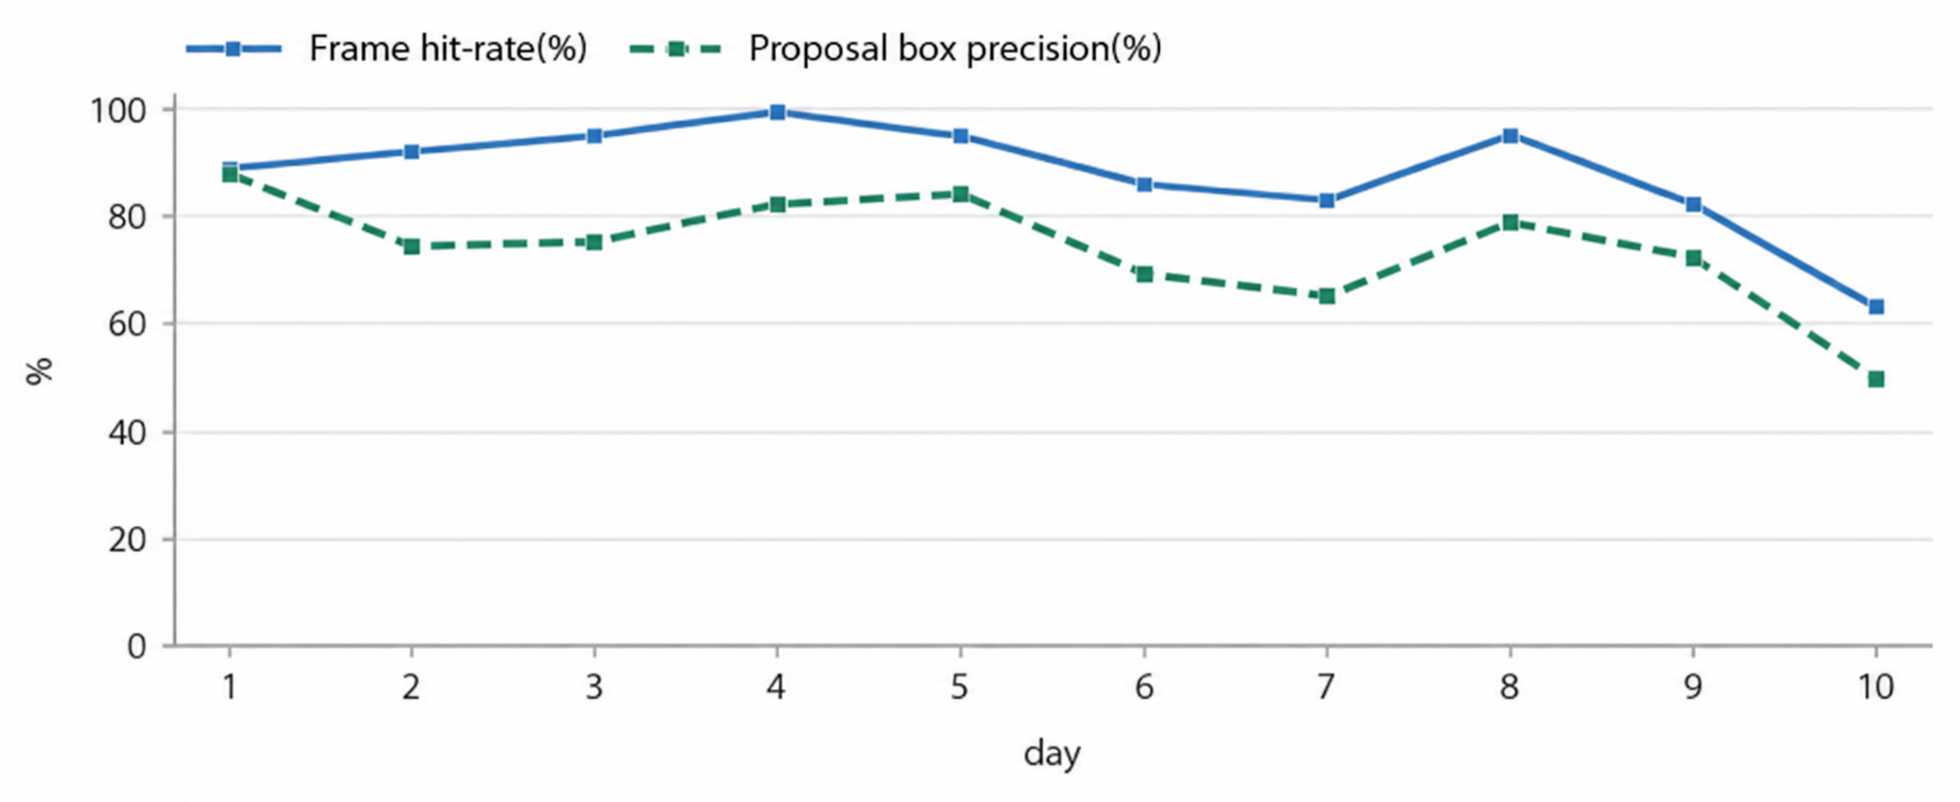
프레임 적중률은 첫째 날부터 아홉 번째 날까지 82.0–99.0%를 기록하며 선택한 프레임 대부분에서 올바른 미탐 후보를 확보하였다. 다만 day 10에는 프레임 적중률과 제안 박스 정밀도가 각각 63.0%와 50.0%로 낮아져 후보 선별의 정확도에 날짜별 차이가 나타났다.
5.2 누적 평가 결과
날짜별 누적 mAP50 성능은 Table 3과 Fig. 5와 같다. day 1에서 Interpolation의 mAP50은 0.7734 ± 0.0113으로 Random의 0.7422 ± 0.0087보다 평균 3.12%p 높았으며, day 2에서도 평균 0.77%p 높은 성능을 보였다. 이를 통해 초기 학습일에는 미탐 후보를 우선적으로 선별한 방법이 무작위 선별보다 높은 성능을 보였음을 확인하였다.
Table 3
Cumulative Evaluation Results (mAP50)
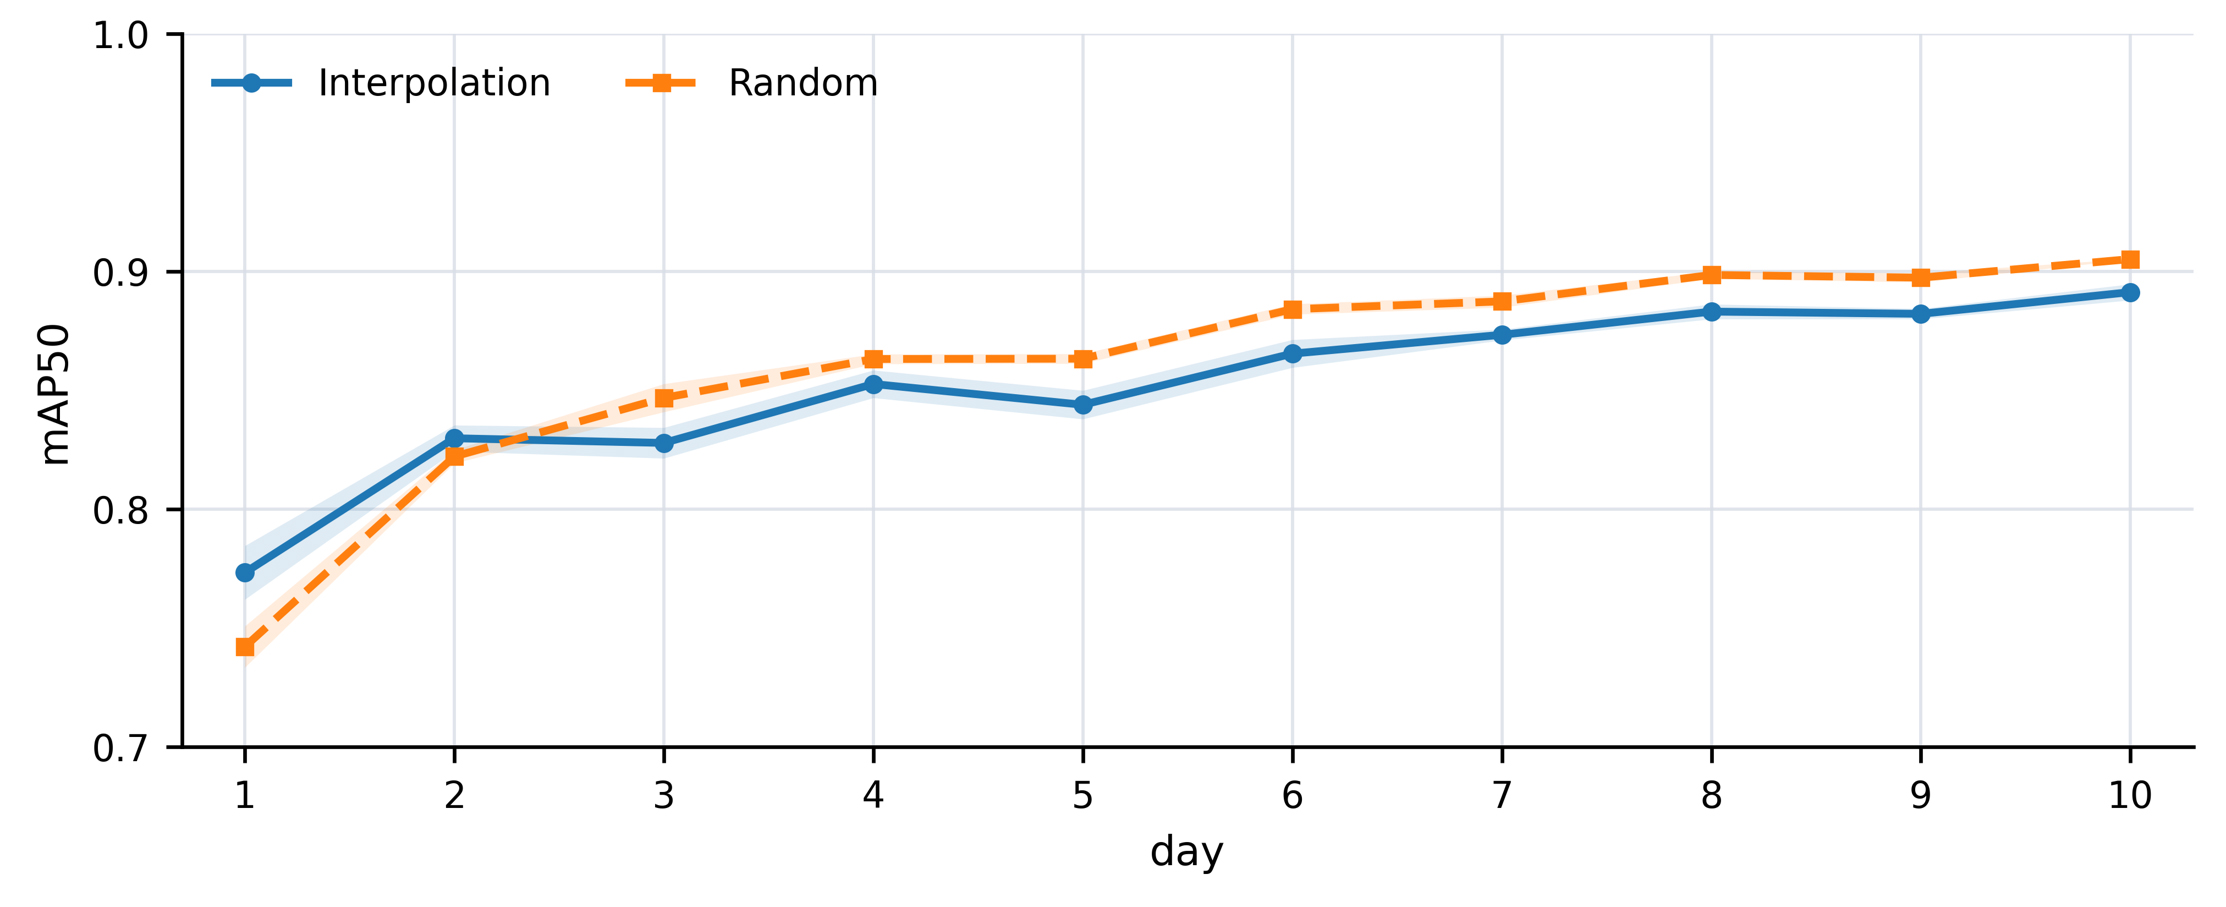
그러나 day 3부터 day 10까지는 Random의 평균 mAP50이 Interpolation보다 높았다. 최종일의 누적 mAP50은 Interpolation이 0.8913 ± 0.0034, Random이 0.9052 ± 0.0002로, Random이 평균 1.39%p 높았다. 따라서 누적 평가에서 Interpolation의 초기 우위는 학습 데이터가 누적되는 전체 기간에 걸쳐 유지되지 않았다.
5.3 다음날 일반화 성능 평가
다음날 일반화 성능 평가 결과는 Table 4와 Fig. 6과 같다. 1–10일차에 학습한 모델을 각각 다음날인 2–11일차의 테스트 데이터에 적용한 결과, Interpolation은 총 10개 평가 구간 중 7개에서 Random보다 높은 mAP50을 기록하였다. 전체 구간의 평균 mAP50은 Interpolation이 0.7603, Random이 0.7435로 Interpolation이 1.68%p 높았다.
Table 4
Next-day generalization performance (mAP50)
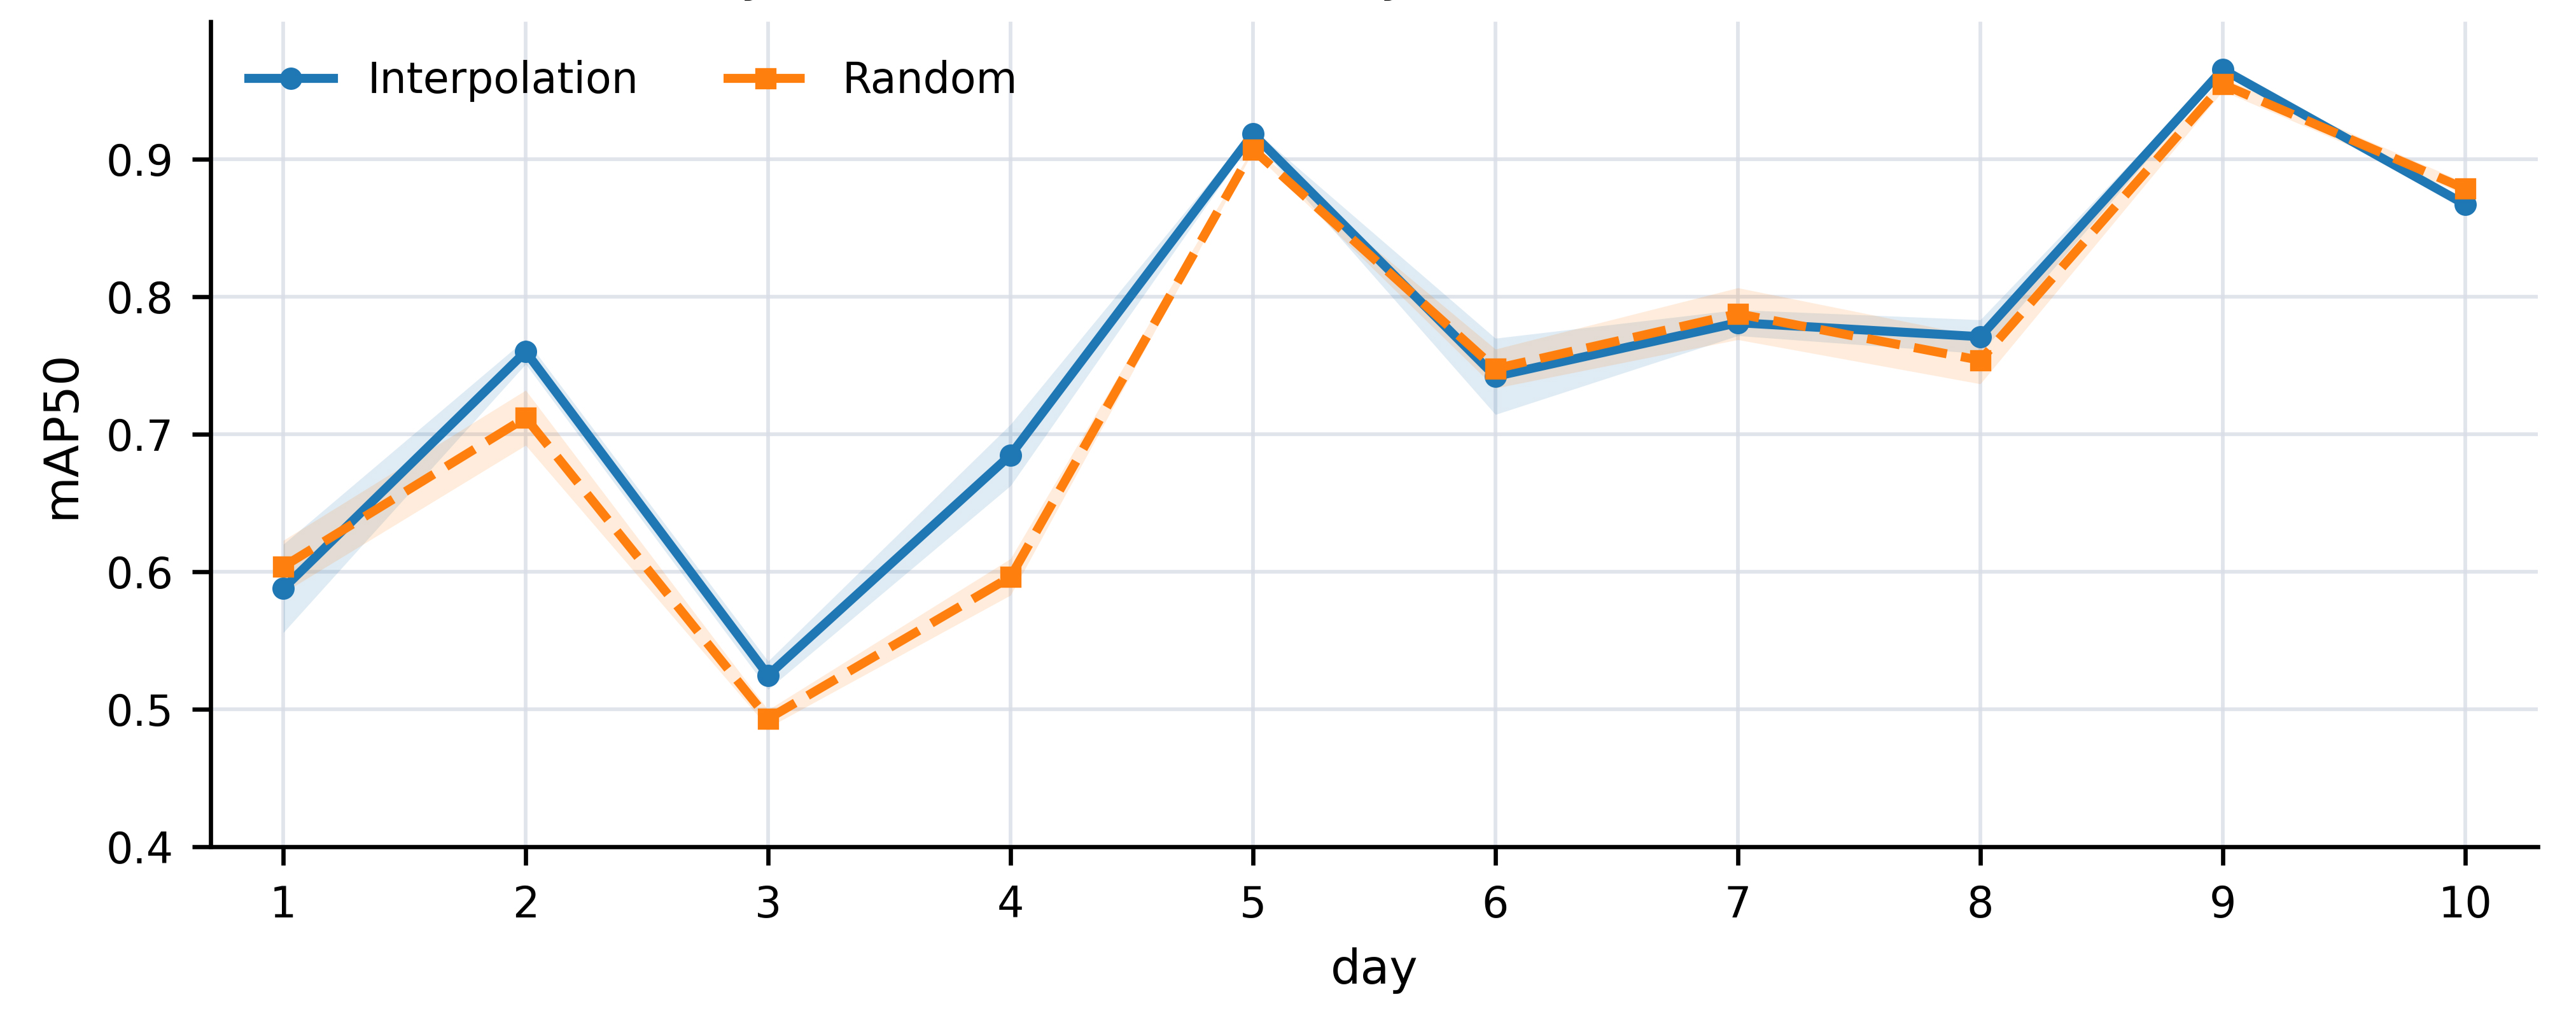
성능차이는 2일차 모델을 3일차 데이터에 평가한 구간과 4일차 모델을 5일차 데이터에 평가한 구간에서 각각 4.81%p와 8.86%p로 크게 나타났다. 특히 4일에서 5일로 이어지는 구간의 mAP50은 Interpolation이 0.6850 ± 0.0223, Random이 0.5963 ± 0.0133로 전체 평가 구간 중 가장 큰 차이를 보였다.
반면, 1일차에서 2일차, 6일차에서 7일차, 7일차에서 8일차, 10일차에서 11일차로 이어지는 구간에서는 Random이 높은 성능을 보였다. 따라서 Interpolation은 다음날 평가에서 평균적으로 높은 객체 탐지 성능을 나타냈으나 성능 개선 크기와 우위 여부는 평가 구간에 따라 상이하게 나타났다.
6. 고 찰
미탐 후보 선별 결과는 전후 프레임의 검출 정보가 현재 프레임의 검출 결과만으로 파악하기 어려운 객체의 위치를 추정하는 단서로 활용될 수 있음을 보여준다. 다만, 미탐 후보 평가에서 프레임 적중률 87.9%와 제안 박스 정밀도 74.0%는 클래스 일치 여부를 확인하지 않는 IoU 0.3 기준에서의 결과이다. 이는 Interpolation으로 추정된 박스의 위치 및 크기 오차를 허용한 완화된 기준이므로 최종 탐지 성능이 아닌 미탐 후보 판정의 유효성만을 나타낸다.
누적 평가에서 Interpolation의 우위가 유지되지 않은 결과는 프레임 전체 라벨링 방식과 다양성을 고려하지 않은 선별 기준의 영향을 받았을 가능성이 있다. 본 실험에서는 선택된 프레임의 모든 객체에 대한 정답 라벨을 학습에 사용하였으므로 미탐 후보 외의 객체 정보도 함께 반영되어 선별 전략에 따른 학습 효과의 차이가 완화되었을 수 있다. 또한, 제안 쿼리는 미탐 가능성을 중심으로 프레임을 선택하므로 유사한 객체나 장면에 선택이 집중될 수 있으며, 이러한 특성이 누적 탐지 성능의 개선을 제한했을 가능성이 있다.
다음날 평가는 당일까지 확보한 데이터로 모델을 학습한 후 이후 수집되는 영상에 적용하는 현장 운영 절차를 반영한다. 이러한 평가에서 평균적으로 높은 탐지 성능을 보인 결과는 미탐 중심의 데이터 선별이 현장 모델의 일별 갱신에 활용될 가능성을 보여준다. 프레임 선별에 사용한 모델이 놓친 객체가 포함된 장면을 학습한 것이 다음날 나타나는 유사한 객체와 장면의 탐지에 도움이 되었을 가능성이 있다.
본 연구에서 라벨링 예산은 선택한 프레임 수를 기준으로 설정하였다. 그러나 동일한 수의 프레임을 선택하더라도 프레임별 객체 수와 장면의 복잡도에 따라 실제 라벨링 작업량은 달라질 수 있다. 또한, 기존에 구축된 정답 라벨을 오라클로 사용하였으므로 실제 작업자의 라벨링 시간과 수정 부담은 측정하지 않았다. 따라서 본 결과의 라벨링 효율은 동일한 프레임 예산에서 확보한 탐지 성능을 기준으로 해석할 필요가 있다.
제안 방법은 전후 프레임에서 검출된 객체를 시간적 근거로 사용하므로, 여러 프레임에 걸쳐 지속적으로 검출되지 않는 객체를 선별하는 데에는 한계가 있다. 또한 미탐 후보 평가는 클래스 일치 여부를 요구하지 않고 IoU 0.3으로 적용하였으므로 후보의 클래스 정확성과 정밀한 위치 추정 성능을 충분히 평가하지 못 할 수 있다. 향후 연구에서는 IoU 임계값과 클래스 일치 조건이 후보 평가 결과에 미치는 영향을 분석할 필요가 있다. 불확실성 및 다양성을 고려한 선별 기준을 결합하고, 서로 다른 환경과 촬영 조건의 건설현장 및 실제 라벨링 작업에서 제안 방법의 적용 효과를 검증할 필요가 있다.
7. 결 론
본 연구에서는 전후 프레임의 검출 박스를 매칭·보간하여 미탐 후보를 선별하는 Interpolation 쿼리를 제안하고, 이를 건설현장 객체 탐지를 위한 능동학습에 적용하였다. 단일 건설현장에서 10일간 매일 100개 프레임을 선별하여 학습한 결과, 프레임 적중률은 87.9%, 제안 박스 정밀도는 74.0%로 나타났다. 누적 평가에서는 무작위 선별 대비 초기 우위가 유지되지 않았으나, 다음날 평가에서는 10개 구간 중 7개에서 더 높은 mAP50을 기록하였으며 평균 차이는 1.10%p였다. 이는 시간적 일관성을 이용한 미탐 중심의 데이터 선별이 동일한 프레임 예산에서 다음날 탐지 성능의 개선에 기여할 가능성을 보여준다.
본 연구는 영상의 시간 정보를 활용한 미탐 후보 선별을 현장 모델의 일별 학습에 연결하고, 그 효과와 한계를 실제 현장 데이터로 확인하였다는 데 의의가 있다. 제안 방법은 지속적으로 수집되는 현장 영상에서 라벨링할 프레임의 우선순위를 정하고 모델을 갱신하는 절차에 활용할 수 있다. 향후 연구에서는 불확실성 및 다양성을 고려한 선별 기준을 활용하여 학습 데이터 구성을 보완하고 서로 다른 환경 및 촬영 조건의 건설현장과 라벨링 작업으로 적용 범위를 확대하여 제안 방법을 추가로 검증할 필요가 있다.